▸ // spis treści
Radula to mój system do zbierania internetu do Obsidiana. Skrypt pobiera surowe dane, Claude Code robi z nich notatki z oceną, a widok Bases pokazuje wynik w tabeli. Rano czytam jedną tabelę zamiast pięciu kart w przeglądarce.
System działa u mnie od kwietnia. Każda warstwa robi jedną rzecz, więc źródła dokładałem po kolei, bez przebudowy całości.
Z tego artykułu dowiesz się:
- jak rozdzielić pobieranie, ocenę i widok, żeby każdą część dało się wymienić osobno,
- jak radula obsługuje GitHub, YouTube, X, zakładki i screeny z telefonu,
- dlaczego tabela Bases wygrywa z raportem w czacie,
- które zasady trzymają system w ryzach po kilku miesiącach.
Sytuacja wyjściowa
Repozytorium ląduje w zakładkach, film w „Obejrzyj później", tweet w polubionych. Trzy stosy w trzech aplikacjach i żaden nie mówi, co z tego jest warte uwagi.
Radula to tarka, którą ślimak zdrapuje pokarm. Mój system robi to samo z internetem: zbiera stosy w jednym miejscu, ocenia je i usuwa to, czego nie ruszyłem przez dwa tygodnie.
Co zrobiłem: trzy warstwy
| Warstwa | Kto robi | Wynik |
|---|---|---|
| pobieranie | n8n na serwerze i skrypty w Pythonie | surowe pliki w ukrytym katalogu .data |
| ocena | Claude Code według pliku z instrukcją | notatka ze streszczeniem i właściwościami |
| widok | Bases w Obsidianie | tabela z filtrami i sortowaniem |
Zasada, która oszczędziła mi najwięcej przeróbek: żadna warstwa nie wie, jak działa sąsiednia. Skrypt nie ocenia, Claude nie pobiera z bazy, widok niczego nie liczy. Zmieniam format notatki, a skrypt zostaje bez zmian.
Pobieranie: surowiec do katalogu .data
n8n zapisuje znalezione rzeczy do bazy MySQL: repozytoria, nowe filmy z subskrybowanych kanałów, tweety po słowach kluczowych. Skrypt w Pythonie ściąga z bazy tylko nowe wpisy i zapisuje je jako pliki w 80_RADULA/.data/.
Film, którego transkrypcję już pobrałem, dostaje w bazie flagę. Następny przebieg go pomija i nic nie przychodzi dwa razy.
Dwa źródła nie mają skryptu. Strony zapisuję Web Clipperem prosto do vaulta, a screeny z telefonu trafiają do katalogu z datą dnia.
Ocena: jeden plik instrukcji na źródło
Każde źródło ma swoją komendę w Claude Code i swój format notatki. Dla repozytorium to:
---
title: "Nazwa repozytorium"
source: "URL do GitHub"
created: 2026-09-16
description: "Esencja repozytorium w jednym zdaniu"
difficulty: "beginner/intermediate/advanced"
target_audience: "kto powinien tego użyć"
tags:
  - automation
---
Pod frontmatterem idą trzy sekcje: streszczenie, najwyżej pięć najważniejszych punktów i cytaty z README przetłumaczone na polski. Nazwy narzędzi dostają wikilinki, więc repozytorium o n8n samo podpina się pod moją notatkę o n8n.
Każdy plik instrukcji mówi też, czego Claude nie robi. Przy YouTube pracuje wyłącznie na transkrypcji, bez szukania w sieci. Przy X wyłącznie na pobranym pliku. Model bez takiego zakazu dopowiada rzeczy spoza źródła, a ja chcę wiedzieć, co powiedział autor, nie co model o tym sądzi.
Widok: Bases zamiast raportu w czacie
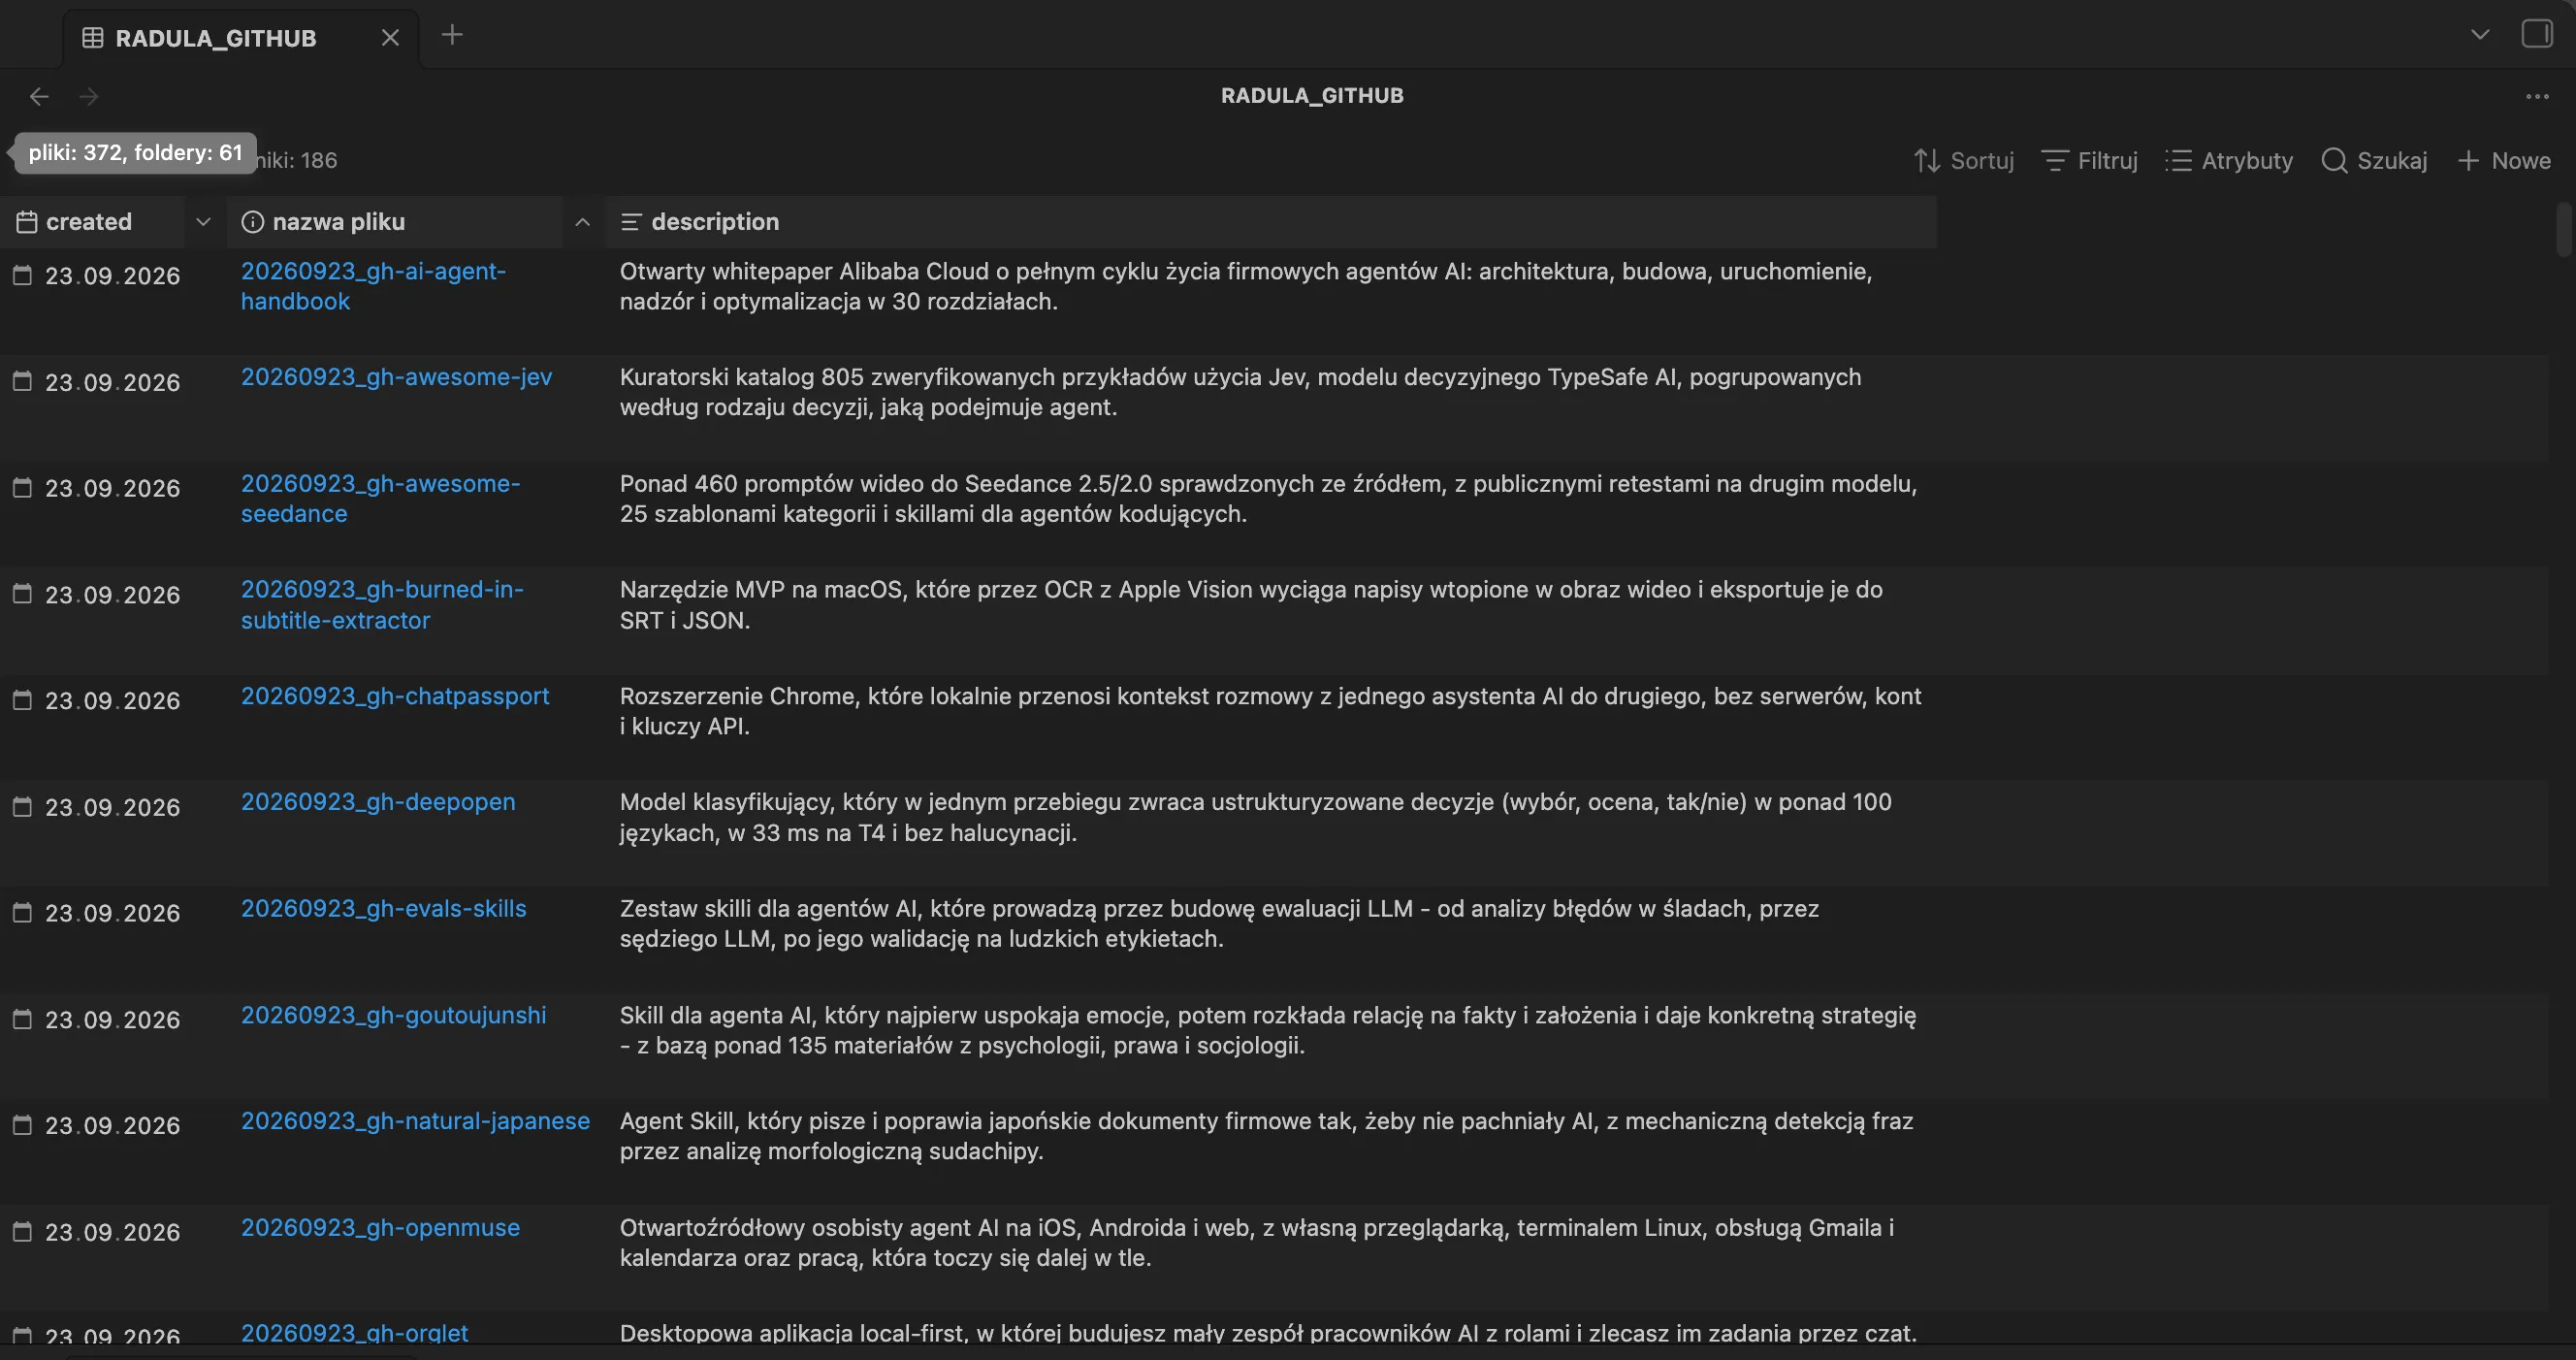
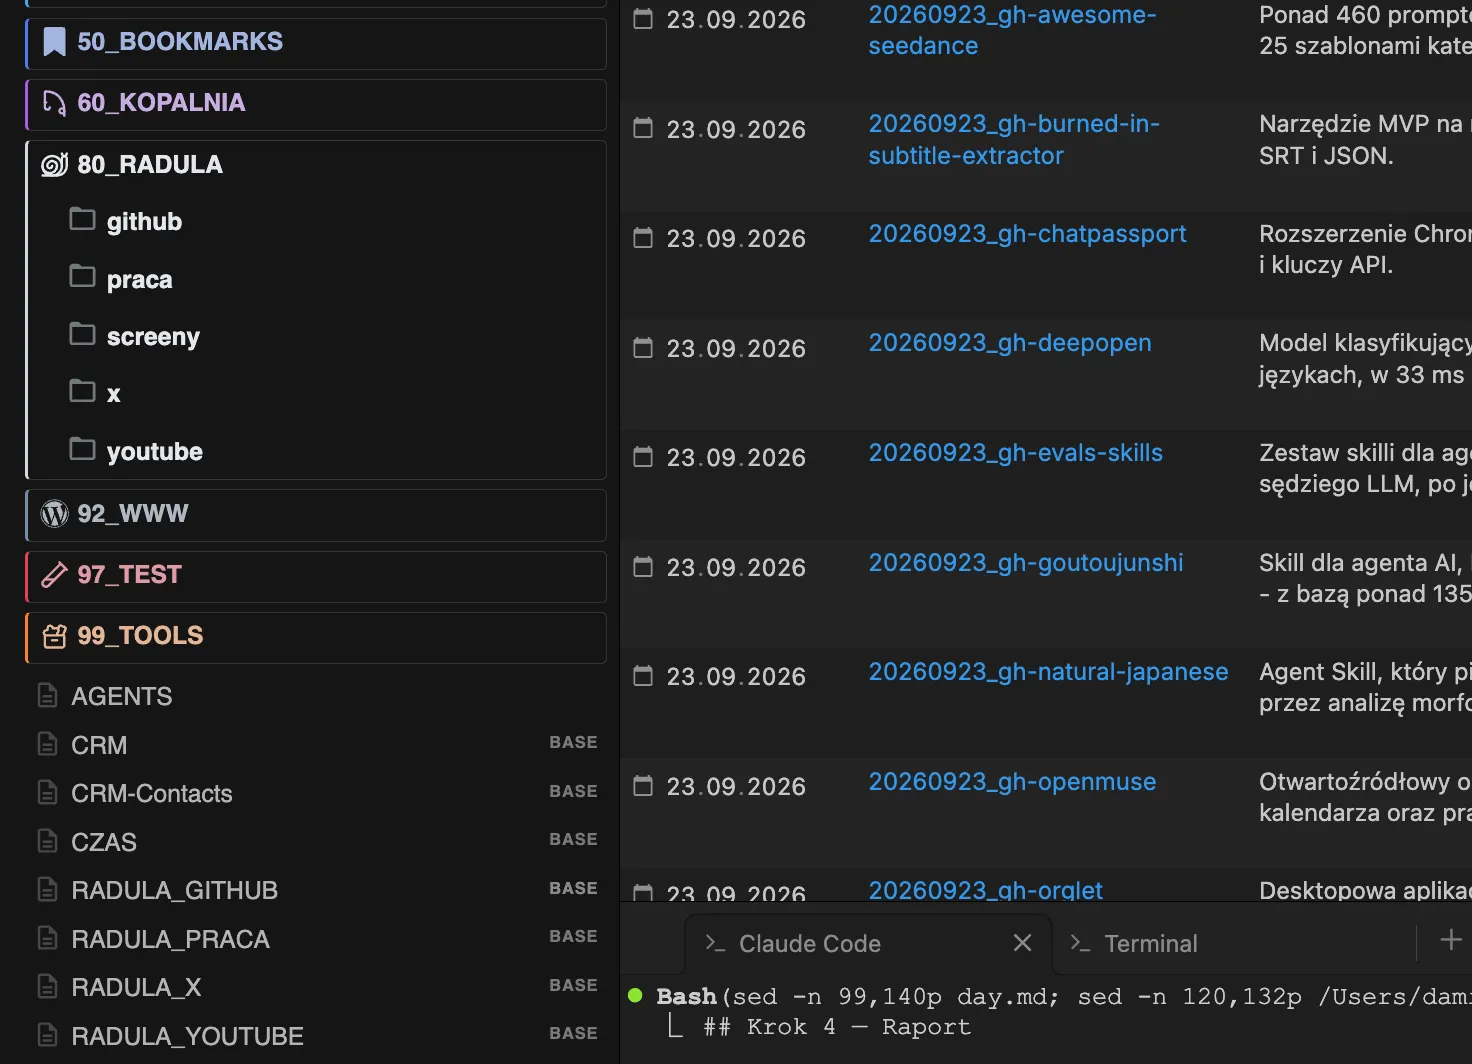
Bases to wbudowana wtyczka Obsidiana, która robi tabelę z właściwości notatek. Każde źródło ma swój plik .base z filtrem na katalog:
filters:
  and:
    - file.inFolder("80_RADULA/github")
views:
  - type: table
    name: Wszystkie
    order:
      - created
      - file.name
      - description
    sort:
      - property: created
        direction: DESC
Kolumna description to jedno zdanie o repozytorium. Przelatuję wzrokiem kilkanaście wierszy, klikam dwa, reszta sama zniknie.
Pięć źródeł, pięć sposobów obróbki
| Źródło | Skąd dane | Co robi Claude | Gdzie ląduje |
|---|---|---|---|
| GitHub | baza, tabela repozytoriów | analiza README, jeden subagent na repozytorium | 80_RADULA/github |
| YouTube | RSS kanałów i transkrypcje | streszczenie z samej transkrypcji | 80_RADULA/youtube |
| X | tweety po słowach kluczowych | z 300-400 tweetów wybiera 10-15 sygnałów | jeden raport dziennie w 80_RADULA/x |
| strony www | Web Clipper i zakładki | nowy frontmatter, streszczenie, tagi z listy | 30_WIKI, jedyne źródło, które zostaje na stałe |
| screeny | zdjęcia ekranu z telefonu | rozpoznaje narzędzie, szuka repozytorium, daje werdykt | raport z miniaturami w 00_INBOX |
X: selekcja zamiast streszczenia
Tu radula ma najwięcej do odrzucenia. Claude najpierw dzieli tweety na dwie kupki: konkret (liczba, wynik, nowa wersja narzędzia) i śmieci (motywacja bez danych, krypto, polityka, duplikaty tematu).
Z konkretów zostaje 10-15 pozycji. Każda ma dwa-trzy zdania: kto, co zrobił, dlaczego to ważne, plus link. Raport na cały dzień czytam w pięć minut.
Screeny: link, którego autor nie podał
Na Instagramie i LinkedInie widzę narzędzie, robię zrzut i idę dalej. Post prawie nigdy nie ma adresu, bo autor chce komentarzy w stylu „wyślij link".
Radula czyta obraz, rozpoznaje nazwę narzędzia i szuka jego repozytorium. Raport stawia screen po lewej, ustalenia i werdykt po prawej. W minutę decyduję, co warto zbadać, a co wyrzucić.
Screeny zawsze biorę z poprzedniego dnia. Katalog z dzisiejszą datą jeszcze się zapełnia i wieczorne zrzuty by przepadły.
Jedna komenda na cały dzień
Pięć komend odpalanych osobno to pięć okazji, żeby o którejś zapomnieć. Komenda /radula:day przechodzi po wszystkich źródłach:
- skrypty pobierające idą jeden po drugim, bo trzy naraz na jednej bazie kończą się przekroczonym czasem połączenia,
- puste źródło pomija w ciszy, bez pustych raportów,
- awaria jednego źródła nie zatrzymuje reszty, trafia do tabeli ze statusem błędu,
- repozytoria i filmy obrabia równolegle, po jednym subagencie na plik,
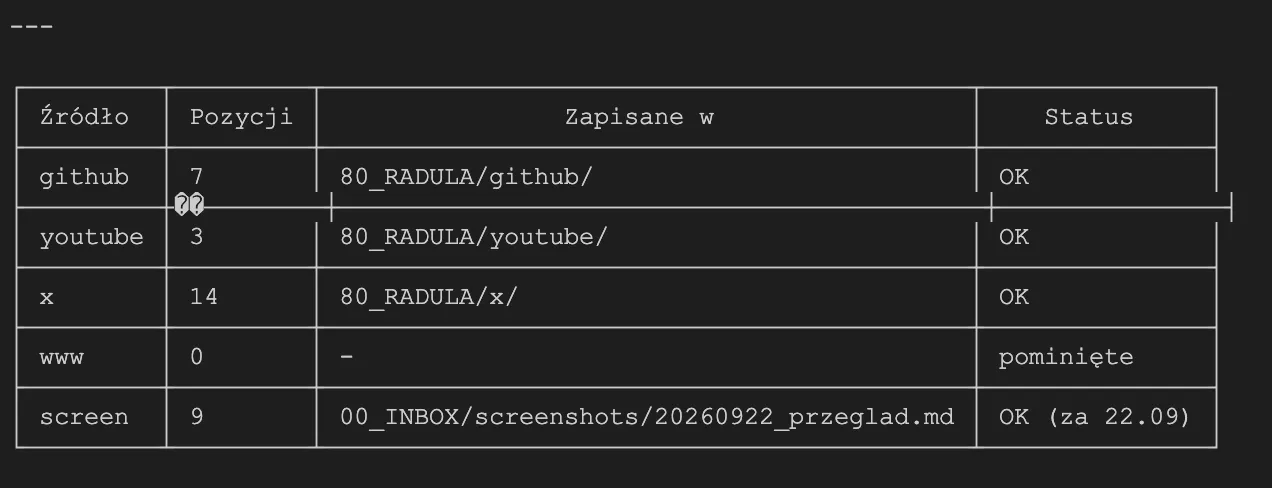
- na końcu zwraca tabelę: źródło, liczba pozycji, gdzie zapisane, status.
Wynik
W ostatnich dwóch tygodniach radula zapisała 217 notatek o repozytoriach i 99 o filmach, czyli około 15 repozytoriów i 7 filmów dziennie. Do tego jeden raport z X na dzień.
Nie czytam tego wszystkiego. Czytam kolumnę z opisem i otwieram kilka pozycji. Reszta znika po 14 dniach, bo skrypt przy każdym uruchomieniu kasuje starsze notatki.
Na tej samej zasadzie działa u mnie system do ofert zleceń i pracy: skrypt pobiera ogłoszenia, Claude przyznaje punkty według mojej tabeli, a widok pokazuje tylko te powyżej progu.
Czego mnie to nauczyło
- Surowiec trzymaj osobno od notatek. Katalog .data jest ukryty, przetworzony plik idzie do katalogu _done. Nic nie przetwarza się dwa razy.
- Format notatki ma mieszkać w jednym pliku. Komenda dzienna nie definiuje własnych formatów, tylko woła komendy źródeł. Zmieniam format w jednym miejscu.
- Tagi tylko z zamkniętej listy. Model sam z siebie napisze raz „ai", raz „AI", raz „sztuczna-inteligencja", a filtr złapie tylko jeden wariant.
- Wiki dostaje tylko to, co wybrałem. Radula wrzuca do katalogu roboczego, a do stałej wiedzy przenoszę ręcznie. Gdzie wszyscy się wykładają: automat, który pisze prosto do bazy wiedzy, po miesiącu zamienia ją w śmietnik.
Podsumowanie
- rozdziel pobieranie, ocenę i widok, każdą warstwę wymienisz wtedy osobno,
- każde źródło dostaje swój plik instrukcji z formatem notatki i listą zakazów,
- Bases pokazuje wynik w tabeli, którą przeglądasz w minutę,
- stare notatki kasuj automatycznie, zostaje tylko to, co przeniesiesz sam,
- jedna komenda dzienna wystarcza, jeśli pomija puste źródła i nie staje na błędzie.
P.S. Widoki Bases, na których stoi radula, działają tak samo jak pulpit z mojego CRM w Obsidianie: filtr na katalog i kolumny z frontmattera.
Częste pytania o Obsidiana: Co to jest Obsidian Bases, Jak używać Obsidiana z AI, Jak używać Dataview.
Damian Ślimak. Twój Nawigator w chaosie AI.