▸ // rozdziały lekcji
Subskrypcje na YouTube przewija algorytm, nie ty. Śledzisz 20 kanałów z branży, a połowę nowych filmów zobaczysz za tydzień albo wcale. Oficjalne YouTube Data API wymaga projektu w Google Cloud, klucza i pilnowania limitów.
Ten workflow omija cały ten cyrk. Każdy kanał YouTube ma publiczny kanał RSS w formacie XML, dostępny bez logowania i bez klucza. n8n czyta go codziennie o 7:40 i dopisuje do tabeli tylko filmy, których jeszcze nie widział.
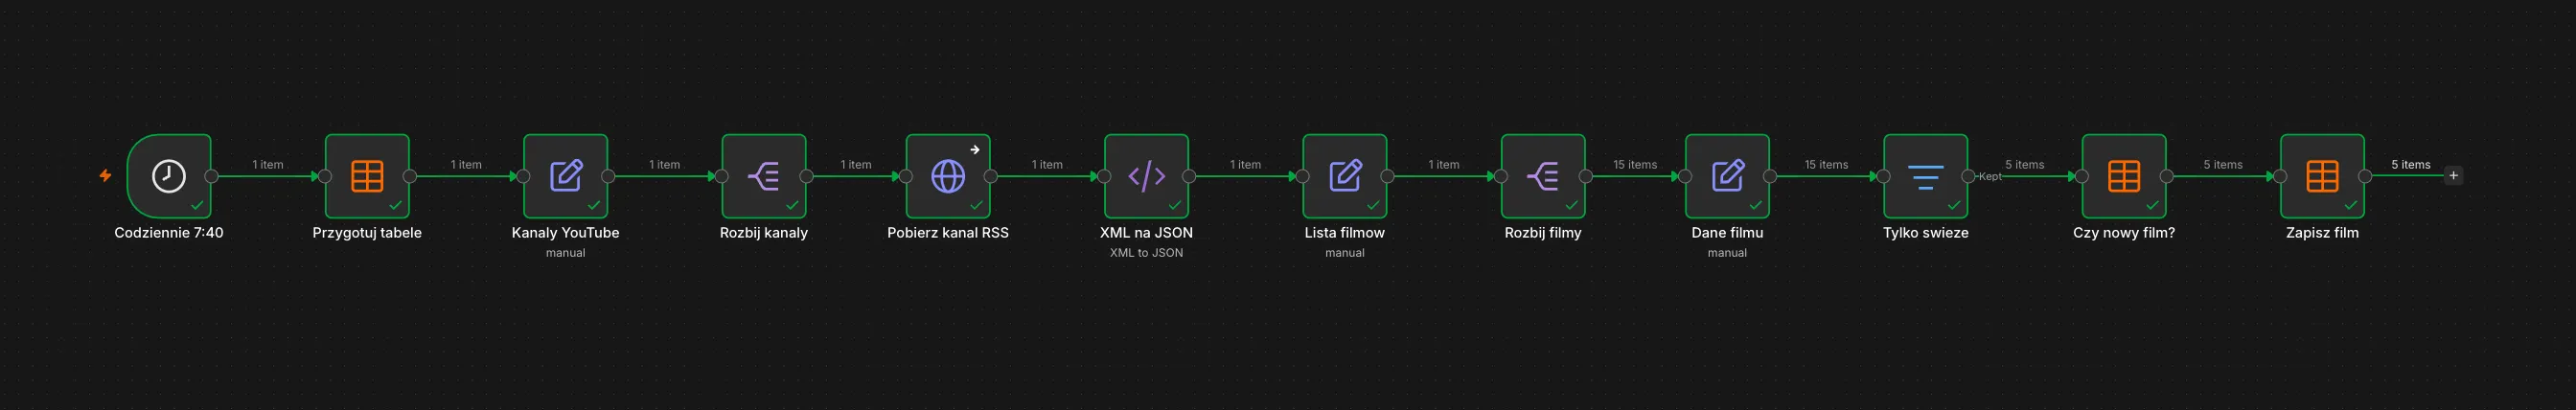
W teście kanał Google for Developers pokazał w RSS 15 filmów. Z ostatnich 14 dni było 5 i te trafiły do tabeli.
Co robi ten workflow
- Codziennie 7:40 - harmonogram.
- Przygotuj tabele - Data Table z operacją Create zakłada tabelę yt_filmy z kolumnami video_id, tytul, link, kanal, opublikowano, opis i dodano. Jeśli tabela już jest, używa istniejącej.
- Kanaly YouTube - Edit Fields z listą ID kanałów w polu
kanalyi liczbą dni wstecz wdni_wstecz(14). - Rozbij kanaly - Split Out, jeden item na kanał, ID w polu
channel_id. - Pobierz kanal RSS - HTTP Request na adres kanału RSS danego kanału.
- XML na JSON - węzeł XML zamienia odpowiedź na JSON.
- Lista filmow - Edit Fields wyciąga listę filmów i nazwę kanału.
- Rozbij filmy - Split Out, jeden item na film, z nazwą kanału dołączoną do każdego.
- Dane filmu - Edit Fields wybiera ID filmu, tytuł, link, kanał, datę i opis.
- Tylko swieze - Filter przepuszcza filmy z ostatnich
dni_wsteczdni. - Czy nowy film? - Row Not Exists po
video_id. - Zapisz film - Insert do tabeli.
Czego potrzebujesz
- ID kanałów YouTube, które chcesz śledzić.
Tyle. Bez klucza API, bez konta Google, bez poświadczeń w n8n.
Skąd wziąć ID kanału
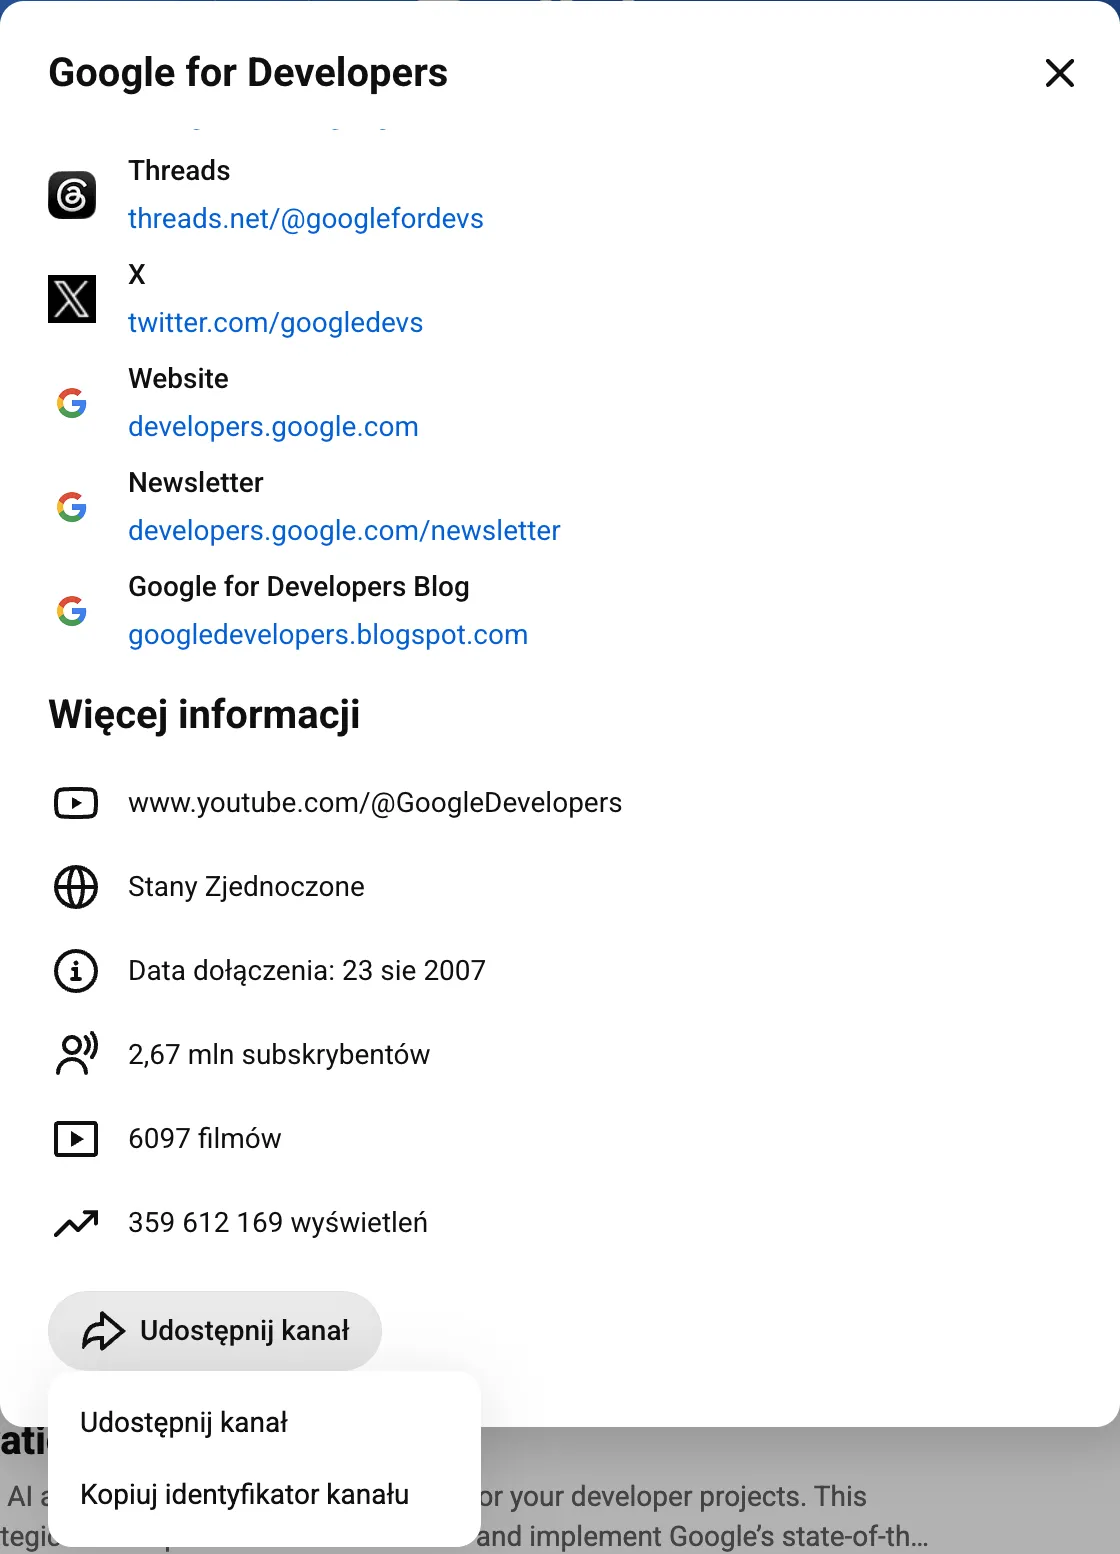
ID kanału zaczyna się od „UC", na przykład UC_x5XG1OV2P6uZZ5FSM9Ttw (Google for Developers, ten jest w pliku). Najprościej skopiujesz je z YouTube:
- Otwórz stronę kanału i kliknij ...więcej przy opisie kanału.
- W oknie przewiń do sekcji Więcej informacji i kliknij Udostępnij kanał.
- Wybierz Kopiuj identyfikator kanału.
Haczyk. W starszych poradnikach przeczytasz, żeby szukać
channelIdw źródle strony. W obecnym kodzie YouTube tego tekstu już nie ma. Jeśli wolisz źródło strony, szukajchannel_id=- stoi w linku do kanału RSS, zaraz przed ID.
Jak uruchomić
- Zaimportuj plik z dołu lekcji (jak importować workflow).
- W węźle Kanaly YouTube wpisz swoje ID w polu
kanaly: tablica w nawiasach kwadratowych, każde ID w cudzysłowie, oddzielone przecinkami. - Ustaw
dni_wstecz, jeśli 14 dni ci nie pasuje. - Kliknij Execute workflow.
- Zajrzyj do tabeli: Overview > zakładka Data tables > yt_filmy.
- Kliknij Publish, żeby harmonogram ruszył (interfejs i publikacja).
Kanał RSS i XML
Adres kanału RSS składa się z jednego parametru:
https://www.youtube.com/feeds/videos.xml?channel_id={{ $json.channel_id }}YouTube oddaje XML. Węzeł XML na JSON zamienia go na strukturę, w której filmy siedzą w feed.entry, a nazwa kanału w feed.title.
W węźle Lista filmow stoi wyrażenie:
{{ [].concat($json.feed.entry || []) }}Po co takie kombinacje? Węzeł XML przy jednym elemencie zwraca obiekt, a przy kilku listę. Kanał z jednym filmem dałby obiekt i Split Out nie miałby czego rozbić. [].concat(...) zawsze robi z tego listę: z obiektu listę jednoelementową, z listy tę samą listę. || [] łapie kanał bez żadnego filmu.
Haczyk. Kanał RSS YouTube pokazuje tylko ostatnie 15 filmów kanału. Jeśli kanał wrzuca kilka filmów dziennie, a workflow nie chodził przez tydzień, część filmów przepadnie. Przy codziennym uruchomieniu i zwykłym kanale ten limit nie przeszkadza.
Pola z dwukropkiem w nazwie
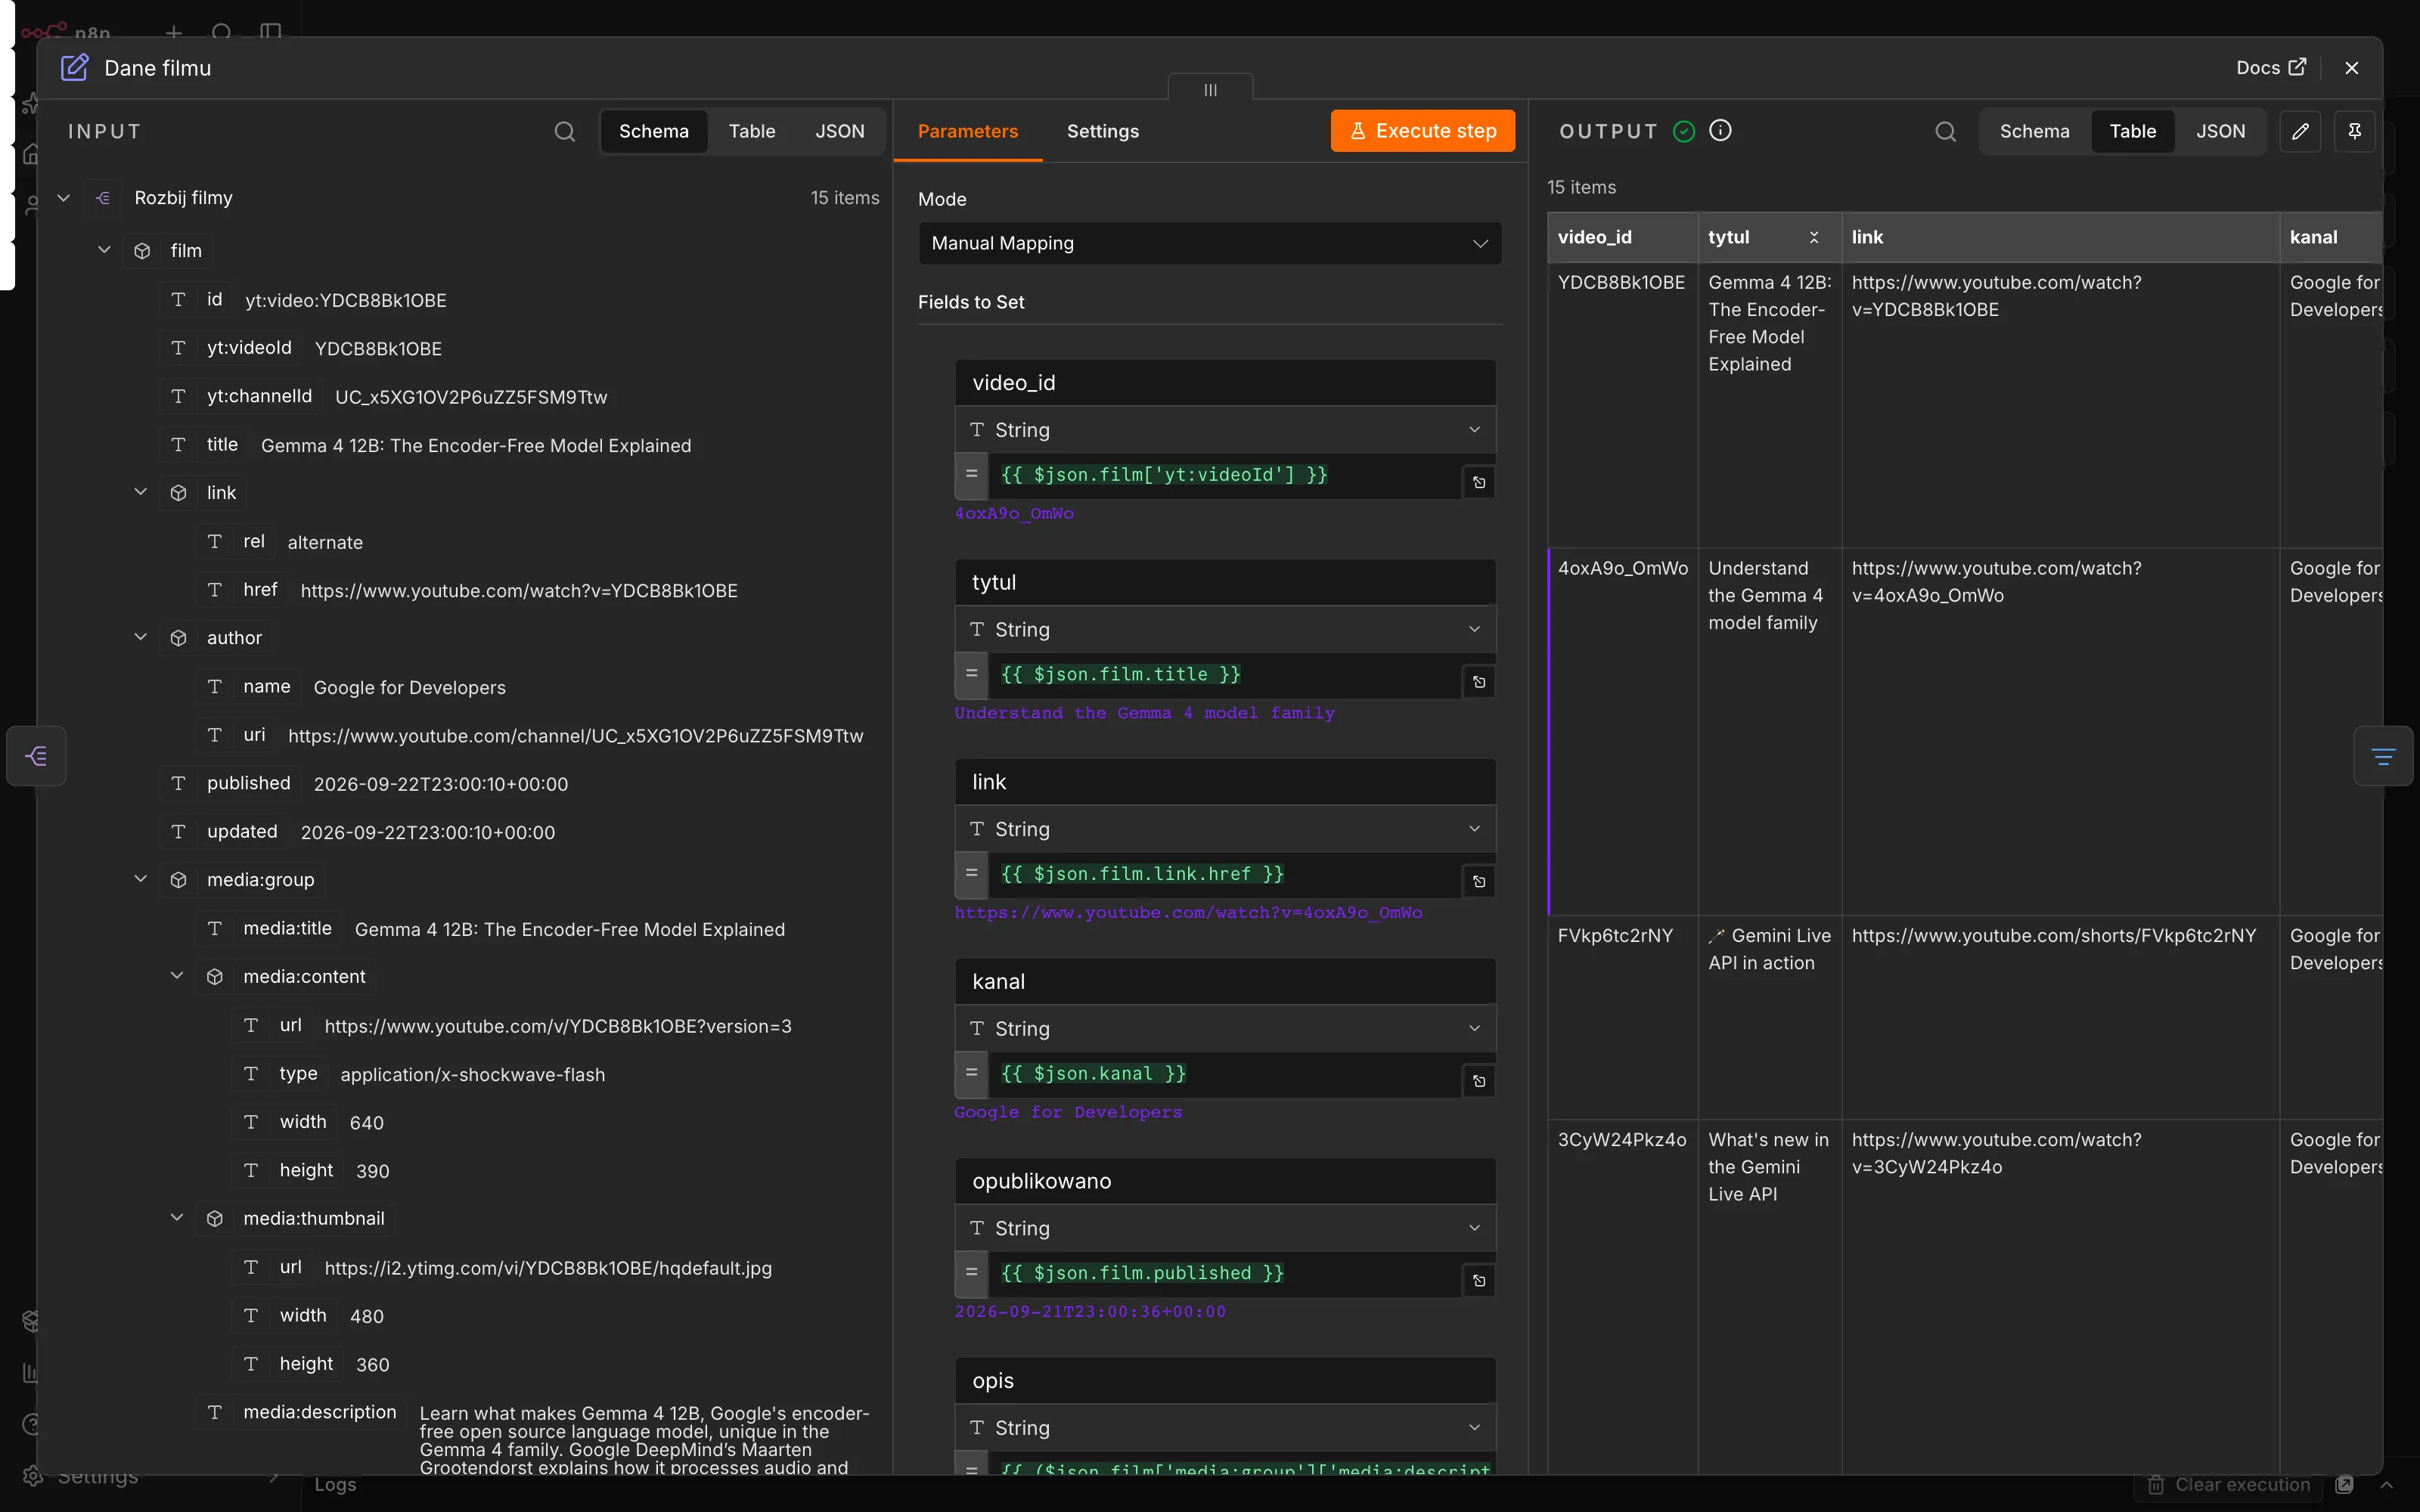
XML YouTube ma pola z przedrostkami, na przykład yt:videoId albo media:group. Zapis z kropką na nich nie działa, bo dwukropek nie może stać w nazwie po kropce. Dlatego wyrażenia w Dane filmu używają nawiasów kwadratowych:
{{ $json.film['yt:videoId'] }}
{{ ($json.film['media:group']['media:description'] || '').substring(0, 1950) }}
Opis filmu siedzi dwa poziomy niżej, w media:group > media:description, i jest przycinany do 1950 znaków. To limit z poprzedniej wersji tej lekcji, w której filmy trafiały do Notiona, a ten przyjmuje do 2000 znaków w polu tekstowym. Czy kolumna tekstowa w Data Table ma własny limit długości, nie sprawdzałem, dlatego przycięcie zostało. Możesz je podnieść albo usunąć na własną rękę.
Poprzednia wersja miała tu błąd: substring(1, 1950) ucinał pierwszą literę każdego opisu, bo liczenie znaków zaczyna się od zera. Teraz stoi substring(0, 1950).
Dwa sita, jak w czytniku RSS
Tylko swieze porównuje datę publikacji filmu z datą sprzed dni_wstecz dni. Czy nowy film? to Row Not Exists po kolumnie video_id: przepuszcza tylko filmy, których ID nie ma jeszcze w tabeli. Drugie uruchomienie nie dopisuje duplikatów.
Tabela zakłada się sama, bo węzeł Przygotuj tabele ma włączoną opcję Reuse Existing Tables. Bez niej drugie uruchomienie kończy się błędem, że tabela o tej nazwie już istnieje. Szczegóły są w lekcji o czytniku RSS.
Pro-tip. Węzeł Pobierz kanal RSS ma w ustawieniach On Error na Continue. Jedno złe ID na liście nie zatrzymuje reszty kanałów. Jeśli któryś kanał nic nie daje, sprawdź w historii wykonań, co zwrócił ten węzeł. Najczęstsza przyczyna to literówka w ID.
Kiedy tego nie używać
Kanał RSS daje tytuł, link, datę i opis. Nie daje liczby wyświetleń, komentarzy ani historii całego kanału. Do raportu ze statystykami potrzebujesz YouTube Data API.
Podsumowanie
Dwanaście węzłów, zero kluczy. Dopisujesz ID kanału do listy, a nowe filmy same trafiają do tabeli co rano o 7:40. Z tej lekcji zabierasz dwa patenty: [].concat(...) na XML, który raz zwraca obiekt, a raz listę, i nawiasy kwadratowe na pola z dwukropkiem.
W następnej lekcji, Monitoring trendów GitHub, n8n codziennie czyta stronę trendujących repozytoriów i zapisuje nowe pozycje, bez AI i bez kluczy.
Pokaż JSON do skopiowania - youtube-rss.json
{
"name": "Nowe filmy z YouTube do Data Table",
"nodes": [
{
"parameters": {
"rule": {
"interval": [
{
"triggerAtHour": 7,
"triggerAtMinute": 40
}
]
}
},
"type": "n8n-nodes-base.scheduleTrigger",
"typeVersion": 1.2,
"position": [
0,
0
],
"id": "b1a1a663-625e-9258-6827-20f11e46f619",
"name": "Codziennie 7:40"
},
{
"parameters": {
"resource": "table",
"operation": "create",
"tableName": "yt_filmy",
"columns": {
"column": [
{
"name": "video_id",
"type": "string"
},
{
"name": "tytul",
"type": "string"
},
{
"name": "link",
"type": "string"
},
{
"name": "kanal",
"type": "string"
},
{
"name": "opublikowano",
"type": "date"
},
{
"name": "opis",
"type": "string"
},
{
"name": "dodano",
"type": "date"
}
]
},
"options": {
"createIfNotExists": true
}
},
"type": "n8n-nodes-base.dataTable",
"typeVersion": 1.1,
"position": [
220,
0
],
"id": "50e04acf-072a-3cab-fe86-01881a9048bd",
"name": "Przygotuj tabele"
},
{
"parameters": {
"assignments": {
"assignments": [
{
"id": "acb80293-8d93-eac1-d363-e821ccf6164f",
"name": "kanaly",
"value": "=[\"UC_x5XG1OV2P6uZZ5FSM9Ttw\"]",
"type": "array"
},
{
"id": "fddbc31b-5a94-cb30-486d-3b8bf08e9470",
"name": "dni_wstecz",
"value": "14",
"type": "number"
}
]
},
"options": {}
},
"type": "n8n-nodes-base.set",
"typeVersion": 3.4,
"position": [
440,
0
],
"id": "cb4ad1e7-35a8-1398-479f-86640b1780af",
"name": "Kanaly YouTube"
},
{
"parameters": {
"fieldToSplitOut": "kanaly",
"options": {
"destinationFieldName": "channel_id"
}
},
"type": "n8n-nodes-base.splitOut",
"typeVersion": 1,
"position": [
660,
0
],
"id": "da5cfc29-ae5d-a5f8-34d9-c8c50bd62425",
"name": "Rozbij kanaly"
},
{
"parameters": {
"url": "=https://www.youtube.com/feeds/videos.xml?channel_id={{ $json.channel_id }}",
"options": {}
},
"type": "n8n-nodes-base.httpRequest",
"typeVersion": 4.4,
"position": [
880,
0
],
"id": "1afafd00-68ed-ea84-a109-e7a72f5f6cff",
"name": "Pobierz kanal RSS",
"onError": "continueRegularOutput"
},
{
"parameters": {
"options": {}
},
"type": "n8n-nodes-base.xml",
"typeVersion": 1,
"position": [
1100,
0
],
"id": "7700c8b7-3511-4597-52ce-7319a59a6598",
"name": "XML na JSON"
},
{
"parameters": {
"assignments": {
"assignments": [
{
"id": "e6f8496c-6b12-c1ce-242b-329a8f94d97d",
"name": "filmy",
"value": "={{ [].concat($json.feed.entry || []) }}",
"type": "array"
},
{
"id": "39882812-7cbf-5910-c605-f6e6b0787016",
"name": "kanal",
"value": "={{ $json.feed.title }}",
"type": "string"
}
]
},
"options": {}
},
"type": "n8n-nodes-base.set",
"typeVersion": 3.4,
"position": [
1320,
0
],
"id": "1cab0270-a285-9b95-8d41-e4ca2d7eaa37",
"name": "Lista filmow"
},
{
"parameters": {
"fieldToSplitOut": "filmy",
"include": "selectedOtherFields",
"fieldsToInclude": "kanal",
"options": {
"destinationFieldName": "film"
}
},
"type": "n8n-nodes-base.splitOut",
"typeVersion": 1,
"position": [
1540,
0
],
"id": "55f46ef3-455f-62a3-c9be-4f31a5437d88",
"name": "Rozbij filmy"
},
{
"parameters": {
"assignments": {
"assignments": [
{
"id": "6c102c0b-b4af-3a80-182f-3bac2096dcae",
"name": "video_id",
"value": "={{ $json.film['yt:videoId'] }}",
"type": "string"
},
{
"id": "56515e7d-44da-0f92-3b57-ea36fb261e24",
"name": "tytul",
"value": "={{ $json.film.title }}",
"type": "string"
},
{
"id": "693e9b66-f812-f262-9a6a-e963d43ecac3",
"name": "link",
"value": "={{ $json.film.link.href }}",
"type": "string"
},
{
"id": "56deb56f-c3a2-64db-76f2-407b55af9796",
"name": "kanal",
"value": "={{ $json.kanal }}",
"type": "string"
},
{
"id": "63e62558-ea92-2ded-2b78-dc20f053ffa6",
"name": "opublikowano",
"value": "={{ $json.film.published }}",
"type": "string"
},
{
"id": "6fe25707-a99b-eb61-69c0-a8c363498807",
"name": "opis",
"value": "={{ ($json.film['media:group']['media:description'] || '').substring(0, 1950) }}",
"type": "string"
}
]
},
"options": {}
},
"type": "n8n-nodes-base.set",
"typeVersion": 3.4,
"position": [
1760,
0
],
"id": "da0e9711-a437-858c-35cb-13686cac2c71",
"name": "Dane filmu"
},
{
"parameters": {
"conditions": {
"options": {
"caseSensitive": true,
"leftValue": "",
"typeValidation": "loose",
"version": 2
},
"conditions": [
{
"id": "f1",
"leftValue": "={{ $json.opublikowano }}",
"rightValue": "={{ $now.minus({days: $('Kanaly YouTube').first().json.dni_wstecz}).toISO() }}",
"operator": {
"type": "dateTime",
"operation": "after"
}
}
],
"combinator": "and"
},
"options": {}
},
"type": "n8n-nodes-base.filter",
"typeVersion": 2.2,
"position": [
1980,
0
],
"id": "5eae4886-fa73-68e5-646b-366385d3e3ac",
"name": "Tylko swieze"
},
{
"parameters": {
"operation": "rowNotExists",
"dataTableId": {
"__rl": true,
"value": "yt_filmy",
"mode": "name"
},
"filters": {
"conditions": [
{
"keyName": "video_id",
"condition": "eq",
"keyValue": "={{ $json.video_id }}"
}
]
}
},
"type": "n8n-nodes-base.dataTable",
"typeVersion": 1.1,
"position": [
2200,
0
],
"id": "63f60264-b199-a964-de7b-c22adfc028a4",
"name": "Czy nowy film?"
},
{
"parameters": {
"operation": "insert",
"dataTableId": {
"__rl": true,
"value": "yt_filmy",
"mode": "name"
},
"columns": {
"mappingMode": "defineBelow",
"value": {
"video_id": "={{ $json.video_id }}",
"tytul": "={{ $json.tytul }}",
"link": "={{ $json.link }}",
"kanal": "={{ $json.kanal }}",
"opublikowano": "={{ $json.opublikowano }}",
"opis": "={{ $json.opis }}",
"dodano": "={{ $now.toISO() }}"
},
"matchingColumns": [],
"schema": [
{
"id": "video_id",
"displayName": "video_id",
"required": false,
"defaultMatch": false,
"display": true,
"type": "string",
"readOnly": false,
"removed": false
},
{
"id": "tytul",
"displayName": "tytul",
"required": false,
"defaultMatch": false,
"display": true,
"type": "string",
"readOnly": false,
"removed": false
},
{
"id": "link",
"displayName": "link",
"required": false,
"defaultMatch": false,
"display": true,
"type": "string",
"readOnly": false,
"removed": false
},
{
"id": "kanal",
"displayName": "kanal",
"required": false,
"defaultMatch": false,
"display": true,
"type": "string",
"readOnly": false,
"removed": false
},
{
"id": "opublikowano",
"displayName": "opublikowano",
"required": false,
"defaultMatch": false,
"display": true,
"type": "date",
"readOnly": false,
"removed": false
},
{
"id": "opis",
"displayName": "opis",
"required": false,
"defaultMatch": false,
"display": true,
"type": "string",
"readOnly": false,
"removed": false
},
{
"id": "dodano",
"displayName": "dodano",
"required": false,
"defaultMatch": false,
"display": true,
"type": "date",
"readOnly": false,
"removed": false
}
]
},
"options": {}
},
"type": "n8n-nodes-base.dataTable",
"typeVersion": 1.1,
"position": [
2420,
0
],
"id": "2462448b-f95f-af94-7e77-73e99a6452aa",
"name": "Zapisz film"
}
],
"connections": {
"Codziennie 7:40": {
"main": [
[
{
"node": "Przygotuj tabele",
"type": "main",
"index": 0
}
]
]
},
"Przygotuj tabele": {
"main": [
[
{
"node": "Kanaly YouTube",
"type": "main",
"index": 0
}
]
]
},
"Kanaly YouTube": {
"main": [
[
{
"node": "Rozbij kanaly",
"type": "main",
"index": 0
}
]
]
},
"Rozbij kanaly": {
"main": [
[
{
"node": "Pobierz kanal RSS",
"type": "main",
"index": 0
}
]
]
},
"Pobierz kanal RSS": {
"main": [
[
{
"node": "XML na JSON",
"type": "main",
"index": 0
}
]
]
},
"XML na JSON": {
"main": [
[
{
"node": "Lista filmow",
"type": "main",
"index": 0
}
]
]
},
"Lista filmow": {
"main": [
[
{
"node": "Rozbij filmy",
"type": "main",
"index": 0
}
]
]
},
"Rozbij filmy": {
"main": [
[
{
"node": "Dane filmu",
"type": "main",
"index": 0
}
]
]
},
"Dane filmu": {
"main": [
[
{
"node": "Tylko swieze",
"type": "main",
"index": 0
}
]
]
},
"Tylko swieze": {
"main": [
[
{
"node": "Czy nowy film?",
"type": "main",
"index": 0
}
]
]
},
"Czy nowy film?": {
"main": [
[
{
"node": "Zapisz film",
"type": "main",
"index": 0
}
]
]
}
},
"settings": {
"executionOrder": "v1"
},
"active": false
}